WPS PDF扫描件识别使用指南
功能摘要
将扫描件PDF中的文字识别为可搜索、可复制的文本,支持单文档和多文档批量识别。
功能说明
| 功能维度 | 说明 |
|---|---|
| 会员限制 | 需要开通会员 |
| 版本限制 | 无版本限制 |
操作步骤
功能区选择单文档识别
功能入口
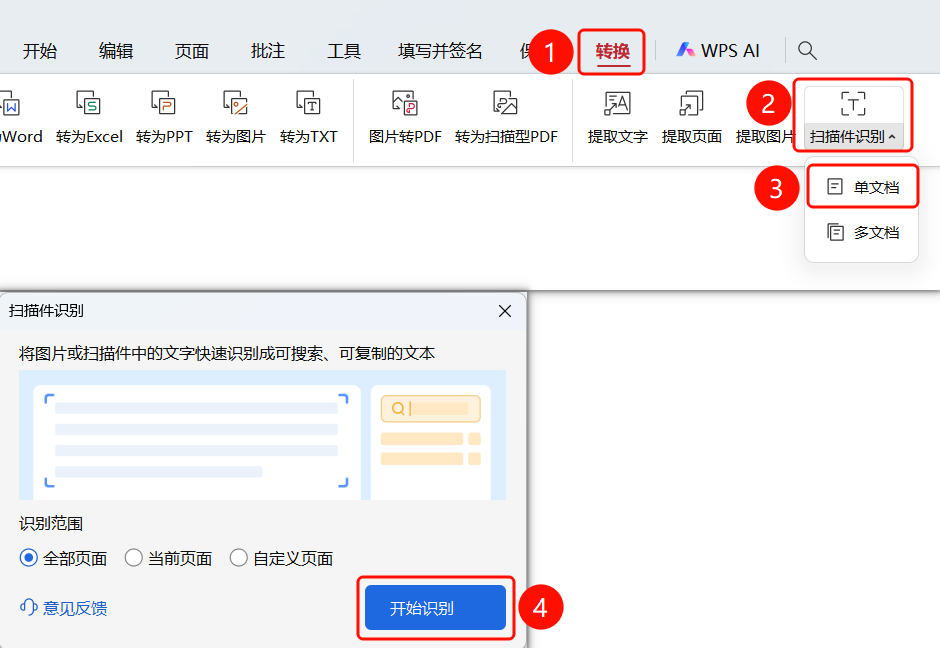
「转换」选项卡→「扫描件识别」下拉菜单→「单文档」→「扫描件识别」对话框→「开始识别」按钮
打开需要识别的扫描件PDF文件
点击顶部功能区中的「转换」选项卡
在功能区中点击「扫描件识别」下拉按钮
选择「单文档」选项,识别当前打开的PDF文件
弹出「扫描件识别」对话框
设置识别范围:
- 全部页面:识别文档所有页面(默认)
- 当前页面:仅识别当前显示的页面
- 自定义页面:手动输入需要识别的页码范围
点击「开始识别」按钮,等待OCR识别完成
功能区选择多文档识别
功能入口
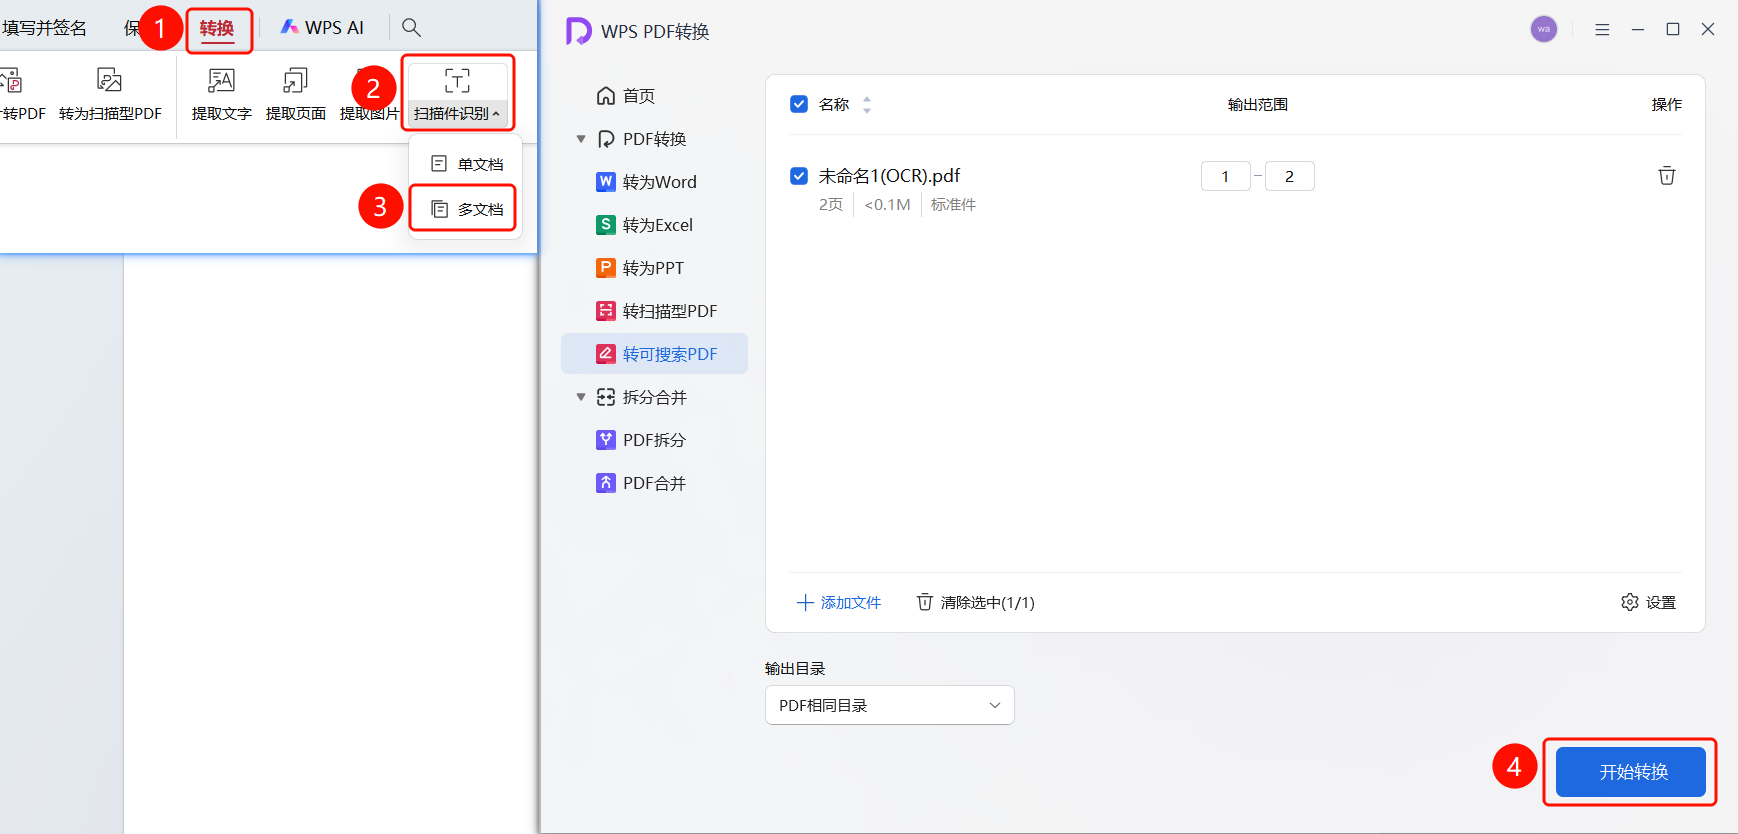
「转换」选项卡→「扫描件识别」下拉菜单→「多文档」→「WPS PDF转换」窗口→「开始转换」按钮
- 点击顶部功能区中的「转换」选项卡
- 在功能区中点击「扫描件识别」下拉按钮
- 选择「多文档」选项,进入批量识别模式
- 弹出「WPS PDF转换」窗口,自动进入「转可搜索PDF」页面
- 点击「添加文件」按钮添加更多扫描件PDF
- 设置每个文件的输出范围(页码)
- 在「输出目录」中设置保存位置
- 点击「开始转换」按钮开始批量识别
常见问题
问题1:识别后的文字有错别字怎么办?
- 解决方案: OCR识别可能因扫描件质量导致误识别,建议识别后手动校对。可先使用「扫描件美化」功能提升画质再识别。
问题2:多文档识别时如何查看进度?
- 解决方案: 在「WPS PDF转换」窗口中,文件列表会显示每个文件的识别状态和进度。
问题3:识别速度太慢怎么办?
- 解决方案: 可缩小识别范围,仅识别需要的页面;或先使用「扫描件美化」中的「增强文本」滤镜提升文字清晰度。
注意事项
- 扫描件清晰度越高,OCR识别准确率越高
- 识别完成后,PDF中的文字将变为可搜索、可复制的文本